DoubleE님이 댓글을 남겼어요
답글 감사드립니다. 소방 안전은 상상도 못했네요. 차량에서는 ISO2626가 정의되고 있고, 반도체 칩 이나 시스템 레벨에서 에러를 검출하는 코드나 회로 이중화 등을 통해 안전 목표를 달성하는데, 그런 기능안전 측면에서의 규격도 있는지 궁금했었네요 ㅎㅎ
댓글 2개 중 최근 것
하이젠버그
하이젠버그 앱에서 열기
DoubleE님이 댓글을 남겼어요
답글 감사드립니다. 소방 안전은 상상도 못했네요. 차량에서는 ISO2626가 정의되고 있고, 반도체 칩 이나 시스템 레벨에서 에러를 검출하는 코드나 회로 이중화 등을 통해 안전 목표를 달성하는데, 그런 기능안전 측면에서의 규격도 있는지 궁금했었네요 ㅎㅎ
댓글 2개 중 최근 것
DoubleE님이 댓글을 남겼어요
기업들이 SW를 migration하고, 큰 차이가 나는 여러 버젼을 관리해야 하고, 검증에 큰 시간을 쏟는 것을 더 부담스러워할 것 같긴 한데, 그런 관점에선 smart ssd 보단 HBF이 유리할 것 같네요

DoubleE님이 댓글을 남겼어요
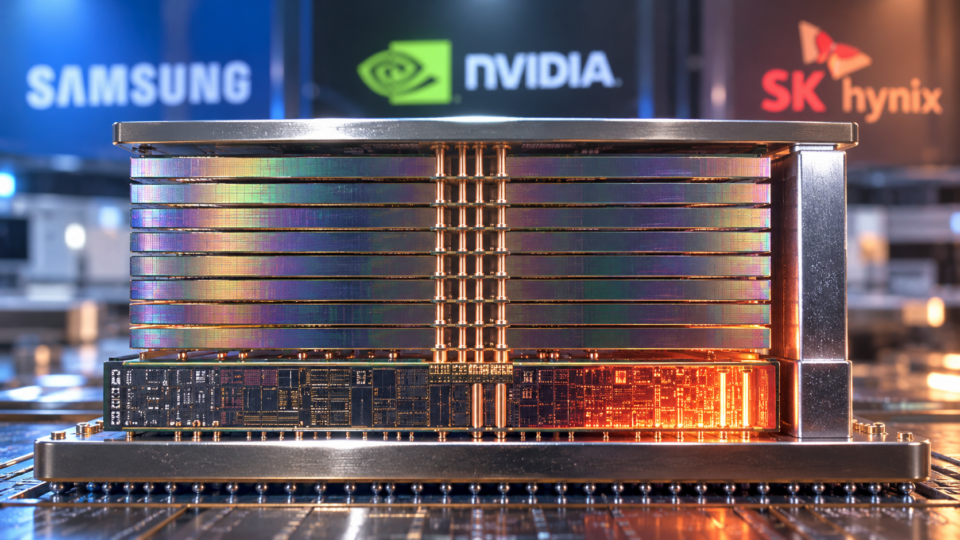
안녕하세요, 글 잘 읽었습니다. 다만 몇 가지 이해되지 않는 부분이 있어 질문 남깁니다. 제가 잘못 이해하고 있을 수도 있지만, 전체적으로 편향된 해석이 아닌가 하는 생각이 듭니다. 1. NVDIA 향 Custom HBM과 삼성의 자체 파운드리 활용에 관하여 궁금한 점이 있습니다. 최근 삼성 역시 엔비디아 향 NVHBM의 베이스 다이 제조에는 TSMC 공정을 활용한다는 기사를 여러 차례 접했습니다. 그렇다면 적어도 NVHBM에 대해서는 삼성의 자체 파운드리 보유에 따른 이점이 상당 부분 줄어드는 것 아닌가요? 더불어 삼성의 로직 파운드리 수준이 TSMC에 미치지 못한다는 것을 간접적으로 알게되는 부분이기도 해보이구요. Standard HBM에서는 말씀하신 장점이 있을 수 있겠지만, 고객 요구사항에 따라 설계와 검증을 반복해야 하는 상황은 오히려 Custom HBM에서 더욱 중요할 것 같습니다. 특히 글의 상당 부분이 NVDIA의 NVHBM을 중심으로 전개되는데, 정작 NVHBM에서는 삼성도 TSMC를 활용한다는 보도가 나온 상황에서 자체 파운드리의 이점을 경쟁력의 핵심으로 보시는 이유가 궁금합니다. 2. HPB와 ICE의 구조적 차이에 대해서도 와닿지 않는 부분이 있습니다. 공개된 다이어그램을 보면 근본적인 방열 원리나 구조가 상당히 유사해 보입니다. 두 기술 모두 D2D PHY 위쪽에 위치하여 발생한 열을 별도로 배출하려는 접근법으로 이해됩니다. 그런데 HPB는 ‘굴뚝’, ICE는 ’얇은 판‘으로 표현하신 이유가 있을까요? 말씀하신 것처럼 ICE의 구체적인 크기와 높이는 공개되지 않은 것으로 알고 있습니다. 그렇다면 ICE가 HPB보다 출입구 영역을 적게 덮거나 상대적으로 작은 냉각 구조물이라는 판단은 어떤 근거에서 나온 것인지 궁금합니다. 두 기술의 실제 형상과 크기가 명확하게 공개되지 않았다면 동일한 기준으로 설명하는 것이 더 객관적인 것 같아서요. 3. Thermal 문제의 실제 개선 대상과 자체 파운드리의 이점에 관해서도 궁금한 점이 있습니다. 글에서 가장 의문스러웠던 부분은 발열 문제가 발생했을 때 Base Die를 반복적으로 재설계하고 제작해야 한다는 전제입니다. 우선 Thermal 문제가 발생한다고 해서 반드시 Base Die를 수정해야 하는 것인지 궁금합니다. HBM의 발열 특성은 Base DIe 뿐 아니라 DRAM Core Die, Die 간 접합 구조, 패키징 소재 등 여러 요소에 의해 결정되는 것으로 알고 있습니다. 따라서 실제 Thermal 문제가 발생했을 때 개선해야 하는 부분이 Base Die인지, DRAM Core Die인지, 아니면 패키징 구조인지에 따라 필요한 설계 변경과 검증 과정이 상당히 달라질 것 같습니다. 특히 문제가 DRAM Core Die나 패키징 구조에 있다면, 삼성의 자체 로직 파운드리 보유가 개발 속도 측면에서 어떤 직접적인 이점을 제공하는지 의문입니다. 또한 HPB나 ICE를 적용한다면 초기 아키텍처 및 floorplan 단계에서부터 해당 구조물이 차지할 영역과 필요한 Thermal Path를 고려해 설계하는 것이 일반적이지 않을까요? 냉각 구조물의 위치와 면적을 초기 설계부터 확보하고, 열해석 시뮬레이션을 통해 목표 온도와 열저항을 충분히 검토한 상태에서 tape-out을 진행한다면, 이후 발열 문제가 발생했다고 해서 base die의 floorplan을 반복적으로 변경해야 할 가능성이 얼마나 클지 궁금합니다. 일반적인 SoC (여기서는 base die) 개발 과정 막바지에 문제가 발생되면, 보통은 기능 검증에서 fail이 발생해서 ECO를 진행하는 것으로 알고 있습니다. 이때 변경 가능한 범위는 굉장히 마이너한 수준으로 이해하고 있습니다. 물론 ECO를 통해 일부 전력이나 발열 특성을 개선할 수는 있겠지만, 근본적인 thermal 문제를 해결할 만큼 대규모로 floorplan이나 아키텍처를 변경하는 것은 단순한 ECO의 범위를 넘어 새로운 제품을 설계하는 수준의 작업일 것입니다. 이를 반복적으로 수행하는 것이 과연 일반적인 개발 과정인지 의문입니다. 로직 공정을 개선할 수 있는 상황이 아니라면 발열 개선을 위해 Base Die의 재제작을 진행하는 상황은 발생하기 어려워보이고, 따라서 과정에서 자체 로직 파운드리를 보유했다는 사실이 얼마나 유의미한 이점을 제공하는지 잘 이해되지 않습니다. 좀 길었는데요,, 제 의문을 정리하면 다음과 같습니다. - HBM5의 Thermal 문제를 해결하기 위해 반복적으로 수정해야 하는 대상이 실제로 base die 가 맞는지, 그리고 이러한 수정 과정이 삼성의 자체 파운드리 경쟁력으로 어떻게 연결되는지에 대한 기술적인 인과관계가 더 설명되면 좋겠습니다. 특히 앞서 말씀드린 것처럼 custom hbm에서 삼성도 tsmc 를 사용한다면, 이러한 이점이 더더욱 유효하지 않겠죠. 위와 같은 궁금증이 있어 의견을 남깁니다. 답변을 받을 수 있을지는 모르겠지만, 다른 분들도 보시고 생각해보셨으면 해서 댓글을 작성했습니다. 관련해 추가적인 설명을 해주신다면 감사하겠습니다.
DoubleE님이 댓글을 남겼어요
글의 주제와 직접적인 연관은 없지만, 새삼 AI로 인해 여러 산업이 서로 시너지를 내며 발전하는 속도가 무섭기도 하고, 한편으로는 도태되지 않을까 하는 두려움이 있네요. AI가 성숙하면서 더 많은 case와 더 다양하고 세밀한 constraint를 적용한 시뮬레이션이 가능해졌을 거고, 더 많은 시뮬레이션을 돌리기 위해 시뮬레이션 load를 줄이기 위한 모델링도 중요해졌을 거고, 그렇게 늘어난 load를 감당하기 위해 서버 성능도 중요해졌겠네요. 그리고 그 서버를 구성하는 XPU 개발을 위해 다시 수 많은 시뮬레이션이 필요할 테고, 필요한 메모리 개발 역시 이 거대한 loop 속에 있을 거구요. 결국 꼬리에 꼬리를 물듯 서로가 서로의 bottelneck이 되고, 그 bottelneck을 해결하기 위해 또 다른 기술이 발전하고, 그렇게 발전한 기술이 다시 다른 기술의 bottelneck이 해결되기를 기다리는 꼴인 것 같네요. 비가와서 그런가.. 새삼 이 거대한 루프를 다시 생각해보게 된 시간이었습니다.
DoubleE님이 댓글을 남겼어요
실리콘 내부 신호가 메탈에서 라우팅 되는 영역에도 광통신이 가능해질 수 있을까요? 전자기간섭이 없어 더 좋을 것 같은데 그런 분야도 연구되고 있는지 궁금하네요.
DoubleE님이 댓글을 남겼어요
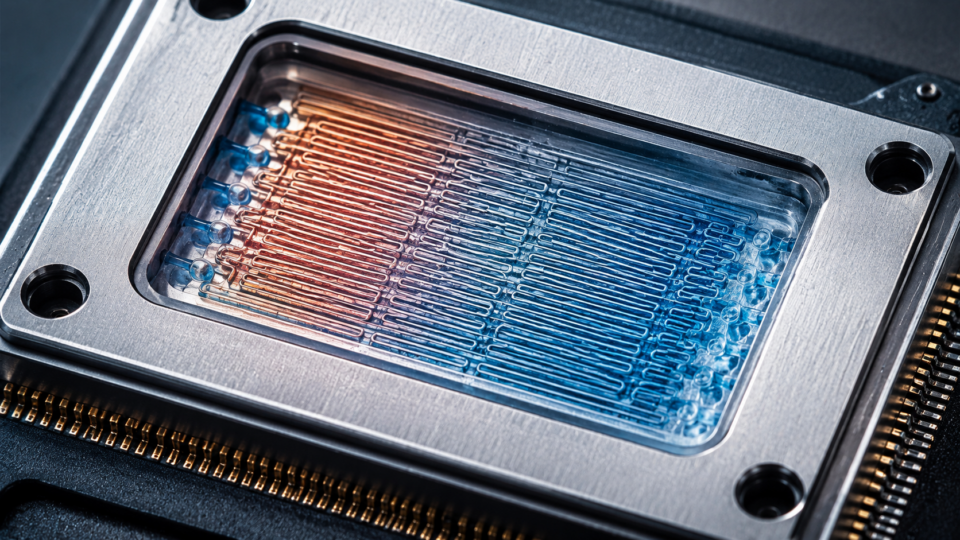
궁금해서 검색하다보니 2-phase cooling이라는 내용(액체 -> 기체로의 상 변화시 많은 열 에너지를 가져가는 것에 착안한 기법?)과 microjet으로 액체를 강하게 분사하는 방식이 있는 것 같습니다. 혹시 이러한 방식들은 microfluidic 과 비교했을 때 어떤가요? 그리고 실리콘을 뚫어서 유체를 흐르게 할 수도 있고 표면만 깎아서 할 수도 있어보입니다. 다른 기술이라고 봐야하는지, 둘 중 더 어려운 게 무엇인지도 궁금하네요
댓글 2개 중 최근 것
DoubleE님이 댓글을 남겼어요
안녕하세요, 잘 아는 분야는 아니지만 궁금한 점 있어서 댓글을 남깁니다. 답변을 해주시는 건지는 잘 모르겠네요 :) 제 이해가 맞는지 궁금합니다 ㅎㅎ NAND에서 MAC 연산을 하는 것에 대한 설명으로 넘어가는 과정에서 맥락을 잘 이해하지 못했네요.. HBM은 AI에서의 대역폭 한계를 극복하기 위해 도입되었다면, HBF는 신경망 파라미터, 즉 메모리 용량을 극복하기 위해서 연구되고 있음. HBF는 Flash memory를 통해 용량을 극복했지만 다음과 같은 문제는 극복 불가. Flash 메모리에 대한 latency와 실제 연산을 위해 main memory (e.g. DDR)에 load 하는 과정은 삭제될 수 없음. 따라서 Flash 메모리에서 연산을 하는 Compute-in-Memory도 연구되고 있음. 이런 흐름으로 이해하는게 맞을까요~?